把教材变成可以解题的本地知识库:一次医学 RAG 实现记录
从图片型医学 PDF、OCR、页码引用,到题型识别和多轮检索,我把一个本地教材检索库推进成了可以交给 Agent 解题的证据层。

把教材变成可以解题的本地知识库
前几天我做了一个很小、但我觉得很有用的项目:把《系统解剖学》第 5 版放进一个本地知识库里。
一开始的目标只是“能搜索教材”。但当我真的输入“肩关节的组成和特点是什么?”时,我发现只返回几段相似文本还不够——我更希望它能识别题型、找到多处证据,再把答案交给 Agent 组织出来。
所以这次开发,我把它从一个教材检索层推进成了一个面向医学题目的证据层:它不擅自编造医学结论,但可以为 Codex 或其他 Agent 准备带页码、章节和原文的作答材料。
1. 第一个问题:PDF 看起来有 368 页,但其实没有文字
原始 PDF 共 368 页。用 PyMuPDF 打开之后,页面可以正常显示,却几乎提取不到文字。这是典型的图片型 PDF:人眼能看,程序却拿不到文本层。
如果直接执行普通导入,程序会得到一个“看起来完成、实际上搜不到内容”的空索引。因此我先接入了 RapidOCR,把每页渲染成图片后识别,再保存成 Markdown。
处理结果保留了几类重要信息:
- 原书页码;
- 章节边界;
- 正文;
- 图注和图例;
- OCR 页面平均置信度;
- 原始页面与处理后文本的对应关系。
最终索引状态是:
书籍:系统解剖学 第5版(处理后教材)
原书页数:368
章节数:18
文本块:460
图片页:0
这里的“页码”指原书页码,而不是 18 个章节文件的数量。中间还修复了一个统计问题:结构化 Markdown 原先会被错误显示成 18 页,现在会从 ## 原书第 XX 页 中计算真实页数。
2. 只有关键词搜索,回答题目时还不够
最初的搜索主要是中文单字、字符片段和关键词出现次数。它对“肱骨”这样的查询还可以,但完整题目里经常有很多通用词:
位置、组成、特点、作用、结构、描述这些词很容易把不相关章节顶到前面。
所以这次增加了一个题目分析层,放在:
medical_rag/qa.py它会做几件事:
- 判断题目类型;
- 去掉“请简述”“下列说法正确的是”等考试套话;
- 提取核心医学概念;
- 生成多组互补查询;
- 对搜索结果去重和重排。
目前支持识别:
- 选择题;
- 填空题;
- 名词解释;
- 比较题;
- 原因题;
- 简答题。
例如:
为什么肩关节容易发生脱位?会被拆成类似下面的检索方向:
完整题干
肩关节 脱位
肩关节
脱位
完整题干负责精确匹配,核心概念负责提高 OCR 场景下的召回率,单概念查询只作为补充,不让它轻易压过完整题干结果。
3. 新的 answer_question 做了什么
在 Library 中新增了:
Library.answer_question(question, limit=6)它返回的不是一句未经验证的“标准答案”,而是一份 citation-first 的证据包:
{
  "status": "evidence_found",
  "plan": {
    "question_type": "short_answer",
    "concepts": ["肩关节"],
    "queries": ["肩关节的组成和特点", "肩关节"]
  },
  "evidence": [
    {
      "book": "系统解剖学 第5版(处理后教材)",
      "page": 53,
      "section": "02-关节学",
      "chunk_id": "...",
      "text": "...",
      "context": []
    }
  ]
}
每个证据块除了自己的原文,还会带上相邻页的文本块。因为简答题经常不是一句话就结束,组成、特点、运动和临床意义可能分布在连续几页里。
这个设计的边界也很明确:
如果本地教材没有返回证据,系统就应该说“知识库未检索到依据”,而不是编一个看起来合理的答案。
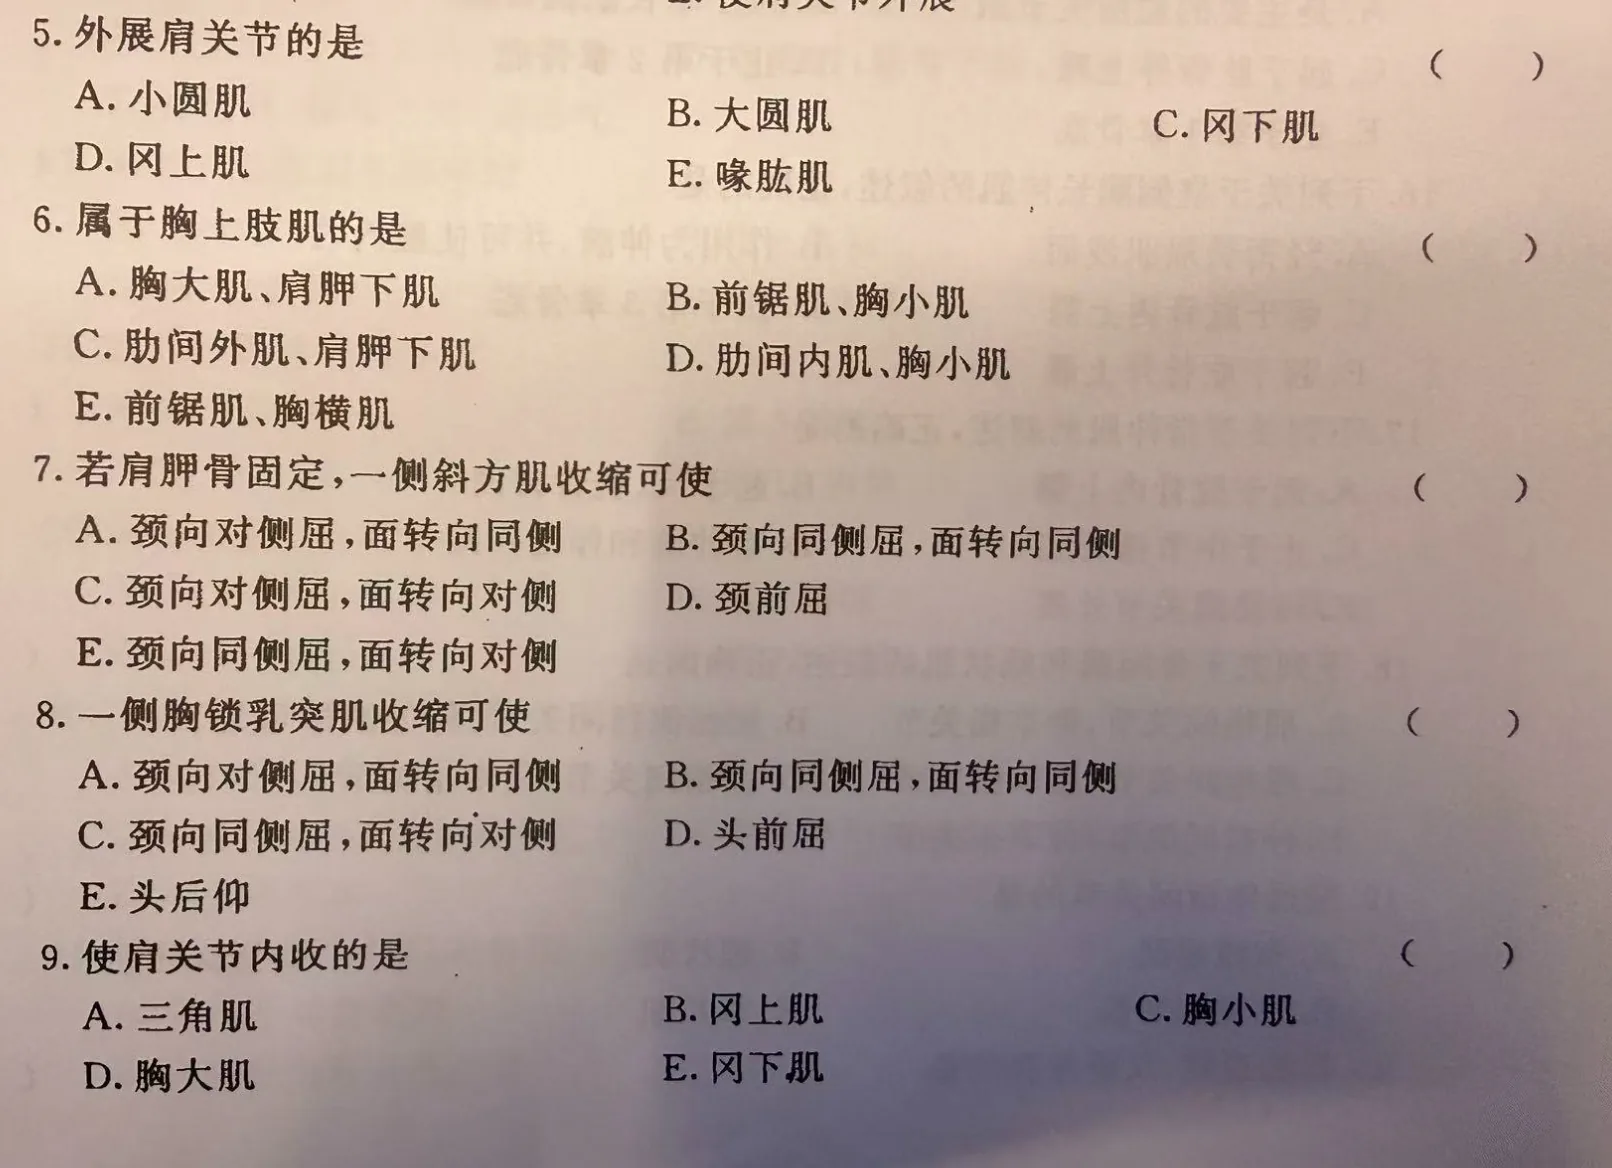
这次我还拿到了一张教材原题的现场截图。题目来自解剖学练习页,图片里的“外展肩关节”“胸上肢肌”“斜方肌”等内容,正好对应知识库需要处理的 OCR、题干和选项信息。
4. 接入 MCP 后,Codex 就可以负责最后一步
项目原本已经有一个 MCP stdio server,提供:
list_books
search_medical_books
get_book_section
这次新增了:
answer_medical_question在 Codex 中,完整流程变成:
用户输入题目
    ↓
answer_medical_question
    ↓
题型识别 + 多轮检索
    ↓
返回教材证据、页码和上下文
    ↓
Codex 根据 evidence 组织最终答案
    ↓
答案附《书名》、原书页码、章节和 chunk_id
我特意没有让本地 Python 服务直接“拍脑袋生成答案”。生成答案是 Agent 擅长的部分,而检索服务更应该专注于把证据找准、保存好、引用清楚。
5. 命令行现在也可以输入题目
普通检索仍然可以使用:
python -m medical_rag.cli search "肱骨的形态特点"如果想走题目分析流程:
python -m medical_rag.cli answer "请简述骨的构造"也可以输出 JSON:
python -m medical_rag.cli answer "为什么肩关节容易脱位?" --json命令行版本目前输出的是证据包,适合交给其他 Agent。接入 Codex MCP 后,Agent 会继续根据证据生成自然语言答案。
6. PiDeck 也被我顺手记录下来了
这次开发时,另一个 Agent 中正好开着 PiDeck。我没有猜测它内部的对话内容,而是直接使用了这张现场截图:PiDeck 中已经出现了基于《系统解剖学》第 5 版处理后教材生成的参考答案。
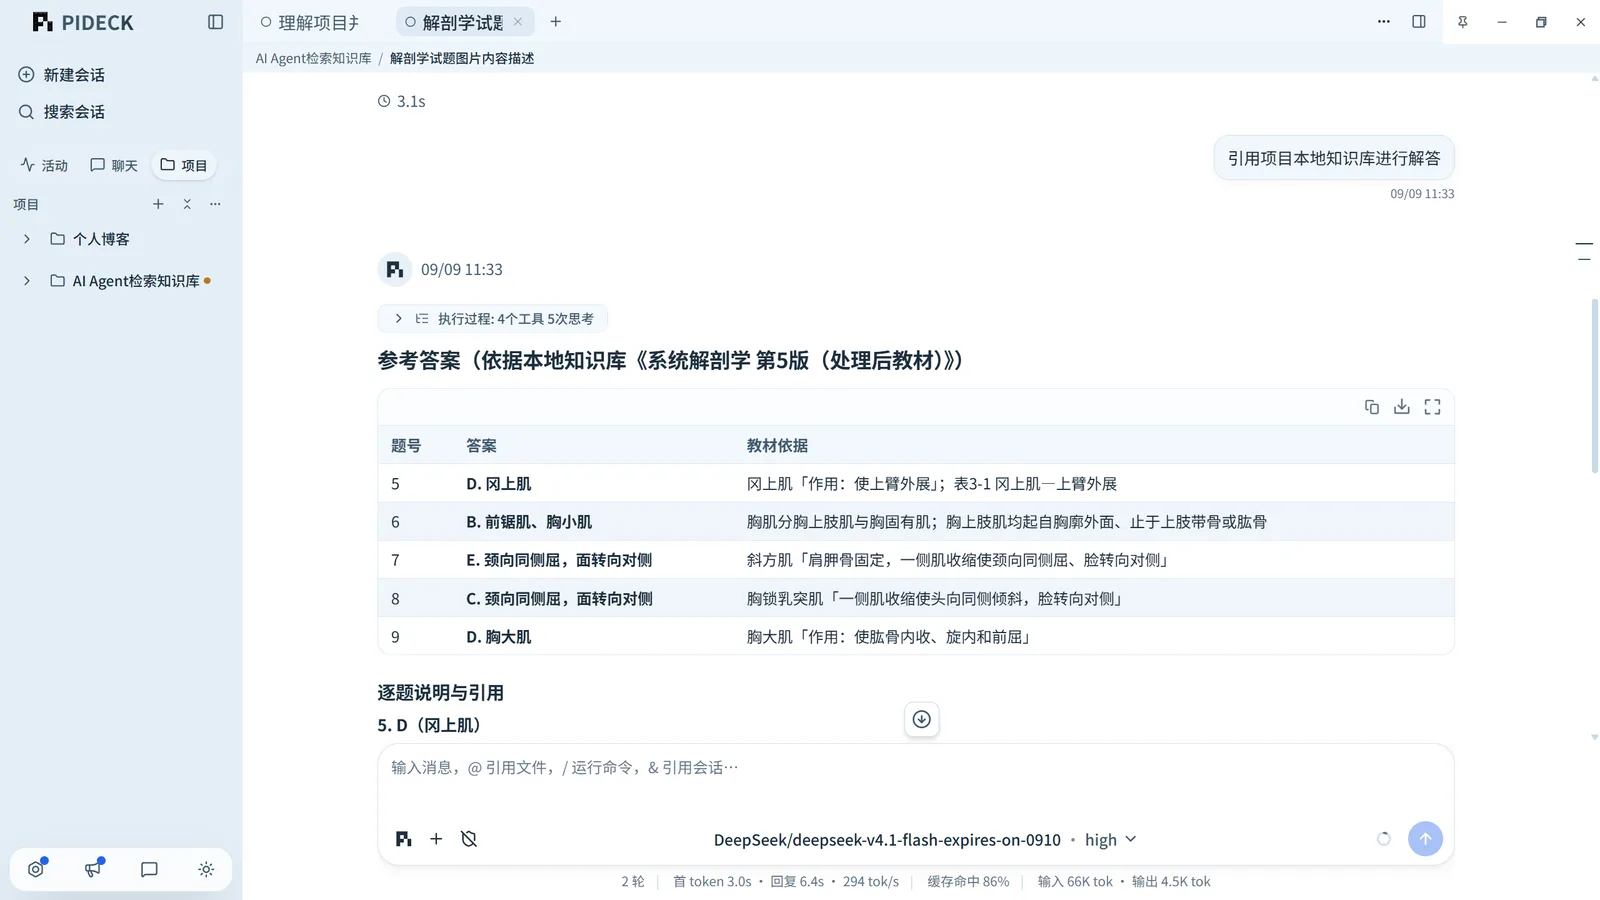
这张图由我在实际运行过程中截取,保留了题目、参考答案、教材依据和模型运行信息;没有补写截图之外的对话内容。另一个 Agent 的 PiDeck 现场,至此也成为这次知识库开发的一部分。
7. 这次改动涉及哪些文件
知识库项目的核心代码位于:
medical_rag/qa.py
medical_rag/library.py
medical_rag/cli.py
medical_rag/mcp_server.py
同时增加了测试:
tests/test_medical_rag.py当前测试覆盖:
- 中文医学概念提取;
- 选择题识别和选项提取;
- 名词解释识别;
- Markdown 教材导入;
- 原书页数统计;
- 题目检索;
- 证据和相邻上下文返回。
测试结果:
Ran 3 tests
OK
8. 还没有解决的问题
这仍然不是一个可以替代教材和老师的系统。当前最明显的不足有:
- OCR 仍会把部分图表、页眉和正文混在一起;
- 中文医学词典和同义词扩展还不够完整;
- 字符匹配对“意思相近但字面不同”的题目支持有限;
- 目前还没有向量检索和 rerank;
- 选择题还没有做到逐个选项的证据核对;
- 命令行尚未接入本地模型,所以不会直接生成最终自然语言答案。
下一步比较值得做的是建立一组带标准页码的医学题目测试集,再引入本地向量索引。这样每次调整检索算法,都可以知道它到底有没有把真正相关的页面排到前面。
结语
我越来越觉得,知识库项目的重点不是“塞进去多少文本”,而是:
能不能找到正确的那一段
能不能说明它来自哪里
能不能在没有证据时停下来
对于医学内容尤其如此。现在这个项目还只是一个本地教材检索层,但它已经可以把一份图片型 PDF 变成 Agent 可调用、可追溯、可以用于题目分析的证据来源。
先让答案有出处,再让答案变得漂亮。这个顺序可能比直接接一个更大的模型更重要。